Qué controla realmente un mapa de profundidad
La imagen en escala de grises que recibe ControlNet Depth no registra luz y sombra. Registra la distancia entre cada píxel y el objetivo. Lo cercano es claro, lo lejano es oscuro, y el contorno de la figura junto con la relación de profundidad entre las partes del cuerpo se comprime en un «mapa de distancias» que el modelo puede leer.
Eso aporta dos beneficios directos: el modelo no se desvía por los materiales, los colores o la iluminación de la imagen original, y al mismo tiempo recibe con exactitud la orientación del cuerpo, la posición de los miembros y las relaciones de oclusión. Si le das un mapa de profundidad de una pose de pie, no copiará la textura de la ropa, pero sí reproducirá el ángulo de la cadera, la elevación del brazo y el punto donde apoyan los pies.
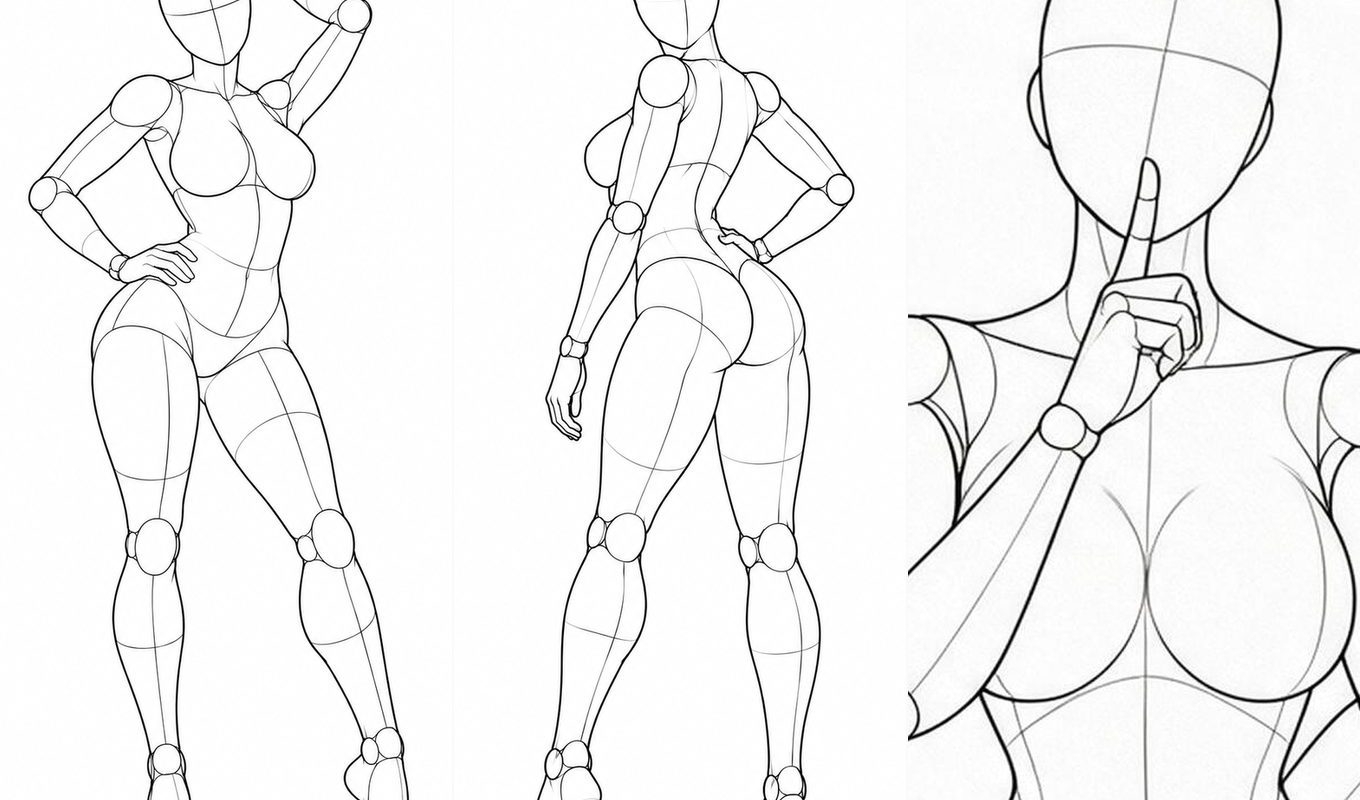
El line art sigue otro camino: describe el contorno y las líneas estructurales, lo que encaja con los trabajos donde hay que conservar el esqueleto del encuadre sin dejar que la escala de grises condicione el tono de piel. El uso eficiente, por tanto, no es elegir uno u otro, sino preparar dos imágenes por pose y usarlas por etapas: mapa de profundidad para fijar el esqueleto en la fase de composición, line art para fijar el contorno en la fase de color.
Paso uno: reducir el catálogo a tres o cuatro poses
La mayoría de la gente se atasca en los parámetros, no en «encontrar la pose correcta». El orden correcto es converger primero y generar después.
- Empieza en la biblioteca de poses y reduce el rango por sistema: elige entre cuerpo entero individual, medio cuerpo individual o pareja.
- Filtra otra vez por categoría: de pie, sentado, de rodillas, apoyado. Sistema y categoría son dos niveles y, combinados, suelen dejar unas decenas de imágenes.
- Fija el ángulo de cámara al final. Cada pose tiene cinco vistas: frontal, cenital, contrapicado, lateral y tres cuartos; la cenital y el contrapicado producen perspectivas completamente distintas. Si eliges mal aquí, todo lo que viene después se desperdicia.
Con tres o cinco basta. Cuando empieces a generar te darás cuenta de que las poses utilizables son muchas menos de lo que imaginas: el problema rara vez está en la cantidad, sino en si has acertado con el ángulo.
Paso dos: cambiar de fuente y hacer una comprobación comparada
En la barra de filtros de la biblioteca de poses hay una opción de «fuente»: mapa de profundidad, line art, comparar. Al pasar a comparar, al pasar el ratón por una tarjeta se cambia en vivo al line art, y en la vista grande se ven ambas en paralelo.
Lo que hay que hacer aquí es sencillo: comprobar que la pose funciona en ambas representaciones. Hay poses cuyo contorno es limpio en el mapa de profundidad y que al pasar a line art difuminan la superposición del brazo con el torso; y también pasa lo contrario, con un line art nítido y un mapa de profundidad con capas confusas. Detectarlo antes es mejor que generar cinco imágenes inútiles y volver atrás.
Paso tres: cómo dar los parámetros en ControlNet
Tomando Stable Diffusion WebUI como ejemplo, la combinación habitual es esta:
- Preprocesador: si usas directamente el mapa de profundidad de la biblioteca, elige
none. Las imágenes de la biblioteca ya están normalizadas y pasar de nuevo por el preprocesador Depth solo resta capas. - Modelo:
control_v11f1p_sd15_depth(SD1.5) o el modelo depth correspondiente de SDXL; la versión debe coincidir con el modelo principal. - Peso: empieza en 0.65. Por debajo de 0.5 la pose se desvía con facilidad; por encima de 0.9 la imagen se vuelve rígida, como un collage pegado encima.
- Momento de control: de 0 a 0.75. Deja que los primeros tres cuartos de los pasos de muestreo estén controlados y reserva el final para que el modelo cierre los detalles.
- Resolución: la imagen de control y la generada deben mantener la misma proporción. Los originales de la biblioteca son 900 × 1200 (3:4); genera también en 3:4 o la figura se estirará.
Los tres problemas más habituales
1. La figura sale como un «maniquí»
El peso es demasiado alto o el momento de control llega hasta los últimos pasos. Baja primero el peso a cerca de 0.7 y sitúa el final del control entre 0.7 y 0.8 para que el modelo resuelva con libertad los pliegues y la expresión en la parte final.
2. Las manos y los pies se deforman
El mapa de profundidad impone poca restricción sobre los dedos: los cinco están casi en la misma capa de profundidad. La solución es reducir el encuadre a medio cuerpo o retocar las manos con inpainting tras la generación. El sistema «medio cuerpo individual» de la biblioteca está pensado justo para estos planos.
3. En las escenas de pareja siempre se pierde la pose de uno
Cuando los valores de profundidad de dos personas se ocultan mutuamente, el modelo no distingue quién está delante. En ese caso conviene recurrir al line art o aclarar un grado el mapa de profundidad del conjunto para separar las capas de profundidad.
Fijar el proceso
En proyectos reales conviene fijar este orden: filtrar ángulo → comparar fuentes → fijar el peso → prueba de una imagen → generación por lotes. Los dos primeros pasos se resuelven en la biblioteca en dos minutos; los tres siguientes son los que realmente consumen tiempo. Poner las acciones baratas al principio es donde el proceso completo resulta más económico.
Las 288 poses y 2.880 imágenes de la biblioteca se pueden descargar directamente, y también obtenerlas en paquetes por sistema. En el siguiente artículo se explica cómo escribir los prompts; puedes seguir por ahí.